ProyectoServerless Back-End
Costo de producción en tiempo real por máquina y producto, desde logs
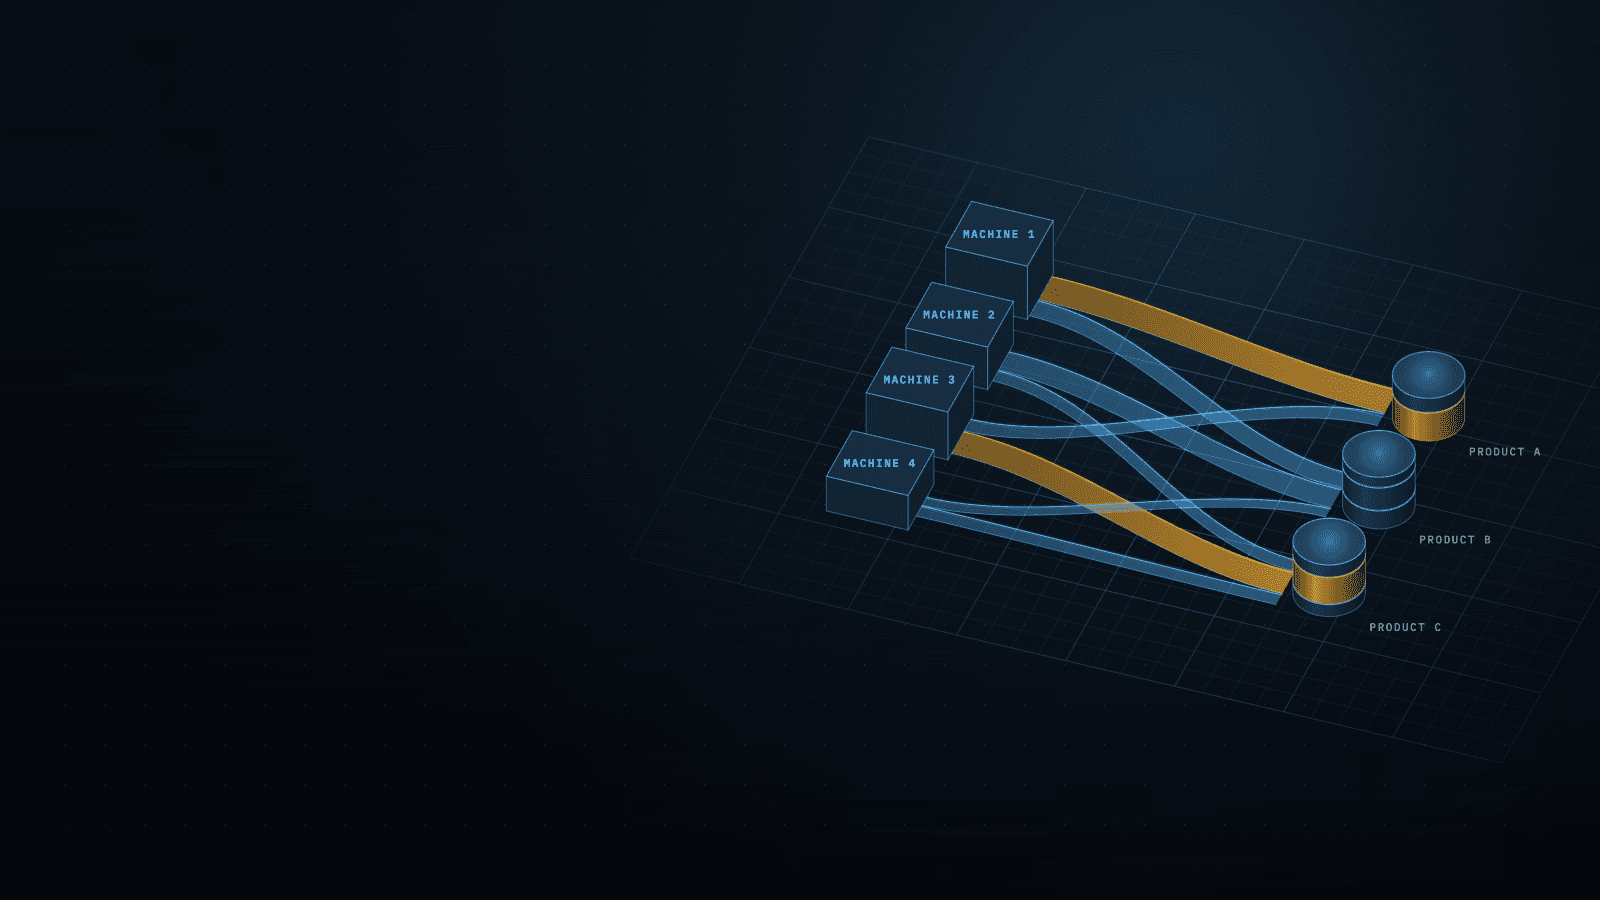
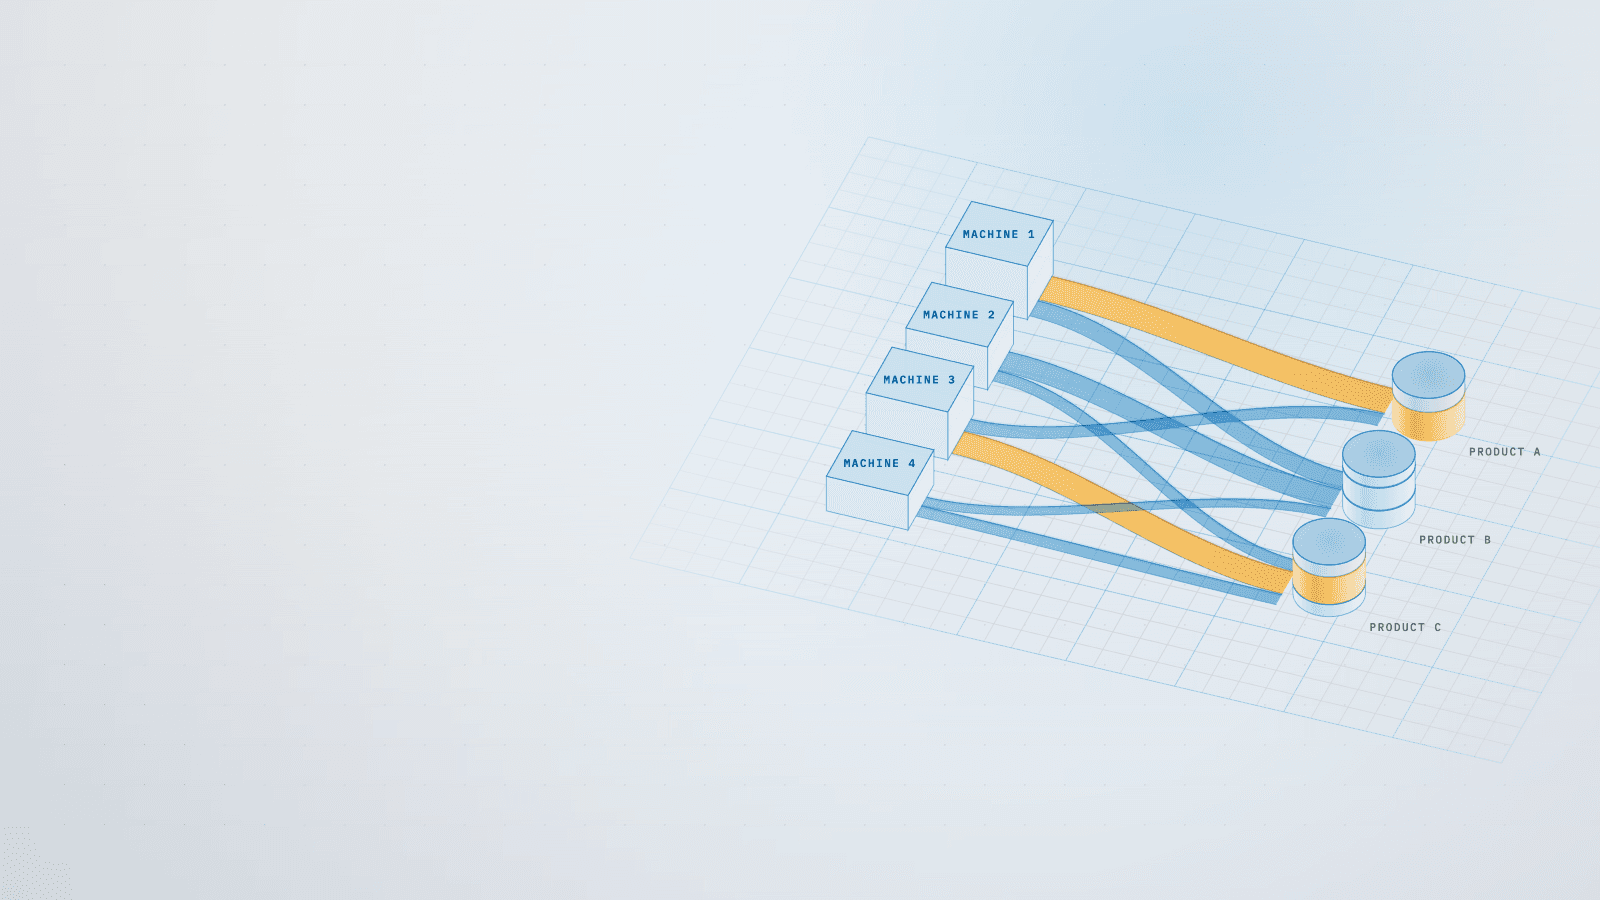
Costo en tiempo real por máquina y producto desde logs de láser, CNC y robots de soldadura; pronostica tiempo de término y costo total.
Stack
- AWS Step Functions
- React.js
- Streamlit
- Support Vector Machine (SVM)
- Python
- Pandas
- DynamoDB
- Kinesis
- +11
01 · Cómo funciona
- HoyaModificado en este trabajo
- Flujo de datos
Qué hace
Una plataforma que convierte los logs de máquinas láser, CNC y robots de soldadura en costo de producción en tiempo real, por máquina y por producto. Un modelo de costos basado en cinco factores (tiempo de operación, energía, material, mano de obra y mantenimiento) valoriza cada corrida, y un modelo entrenado con el historial pronostica el tiempo de término y el costo total de cada proyecto.
Leer más
Construí el pipeline, los modelos de costo y de predicción, y los tableros por máquina que los jefes de proyecto usan para decidir dónde actuar.
6 conexiones· elige un componente para ver su recorrido
- Logs de máquinas a Orquestador de pipeline: logs de 3 tipos de máquina
- Orquestador de pipeline a Almacén NoSQL y objetos: métricas valorizadas
- Almacén NoSQL y objetos a Modelo de costos: tiempo, energía, material
- Almacén NoSQL y objetos a Modelo SVM de término: historial de proyectos
- Modelo de costos a Microtableros de costo: costo por máquina, producto
- Modelo SVM de término a Microtableros de costo: fin previsto, costo total
02Qué logró
Resultado
- Visibilidad de costos: costo en tiempo real por máquina y por producto, construido a partir de cinco factores de costo
- Planificación: pronósticos de tiempo de término y costo total para cada proyecto
Leer más
- Decisiones: desgloses de costo por máquina que muestran adónde se va el dinero
- Pipeline de datos: recolección continua desde tres tipos de máquina, con limpieza y validación en la entrada
El desafío
Un costo solo sirve si es creíble, y los logs de máquina no se escriben pensando en la contabilidad. Cada tipo de máquina registra de forma distinta, así que los datos tuvieron que limpiarse, validarse y enriquecerse con información de costo antes de que cualquier número llegara a un tablero.
Convertir tiempo de operación, energía, material, mano de obra y mantenimiento en un solo costo por producto exigió acordar un modelo suficientemente simple como para explicarlo y suficientemente completo como para confiar en él.
Leer más
El pipeline tenía que correr de forma continua para que los costos se mantuvieran al día, y el modelo de tiempo de término necesitó un entrenamiento cuidadoso con datos históricos antes de que sus pronósticos pudieran guiar decisiones sobre recursos y prioridades.
Qué aprendí
Un modelo de costos funciona cuando quienes lo usan pueden explicarlo. Limitarlo a cinco factores conocidos hizo que los números fueran fáciles de cuestionar y, por lo tanto, más confiables. La mayor parte del esfuerzo estuvo en los datos: validar y enriquecer los logs en la ingesta es lo que hizo creíbles los costos.
Leer más
Mantener el modelo de costos separado del modelo de pronóstico permitió que cada uno cambiara sin romper al otro.
Stack
- AWS Step Functions
- React.js
- Streamlit
- Support Vector Machine (SVM)
- Python
- Pandas
- DynamoDB
- Kinesis
- SQS
- Lambda
- SageMaker
- AWS CloudWatch
- AWS S3
- AWS API Gateway
- AWS CodeCommit
- AWS CodePipeline
- DVC
- Node.js
- Serverless
Habilidades
- Modelado de costos
- Pipelines de datos
- Modelado predictivo
- Tableros operativos
- Plataformas de datos en la nube