ProyectoML clásico
Extracción automática de documentos para un modelo predictivo
Ingesta automática de PDFs y logs de máquina en un modelo predictivo, con OCR, ETL y reentrenamiento mensual, en vez del trabajo manual.
Stack
- S3
- DynamoDB
- Textract
- Lambda
- ECR
- EventBridge
- CloudWatch
- X-Ray
- +7
01 · Cómo funciona
- HoyaModificado en este trabajo
- Flujo de datos
Qué hace
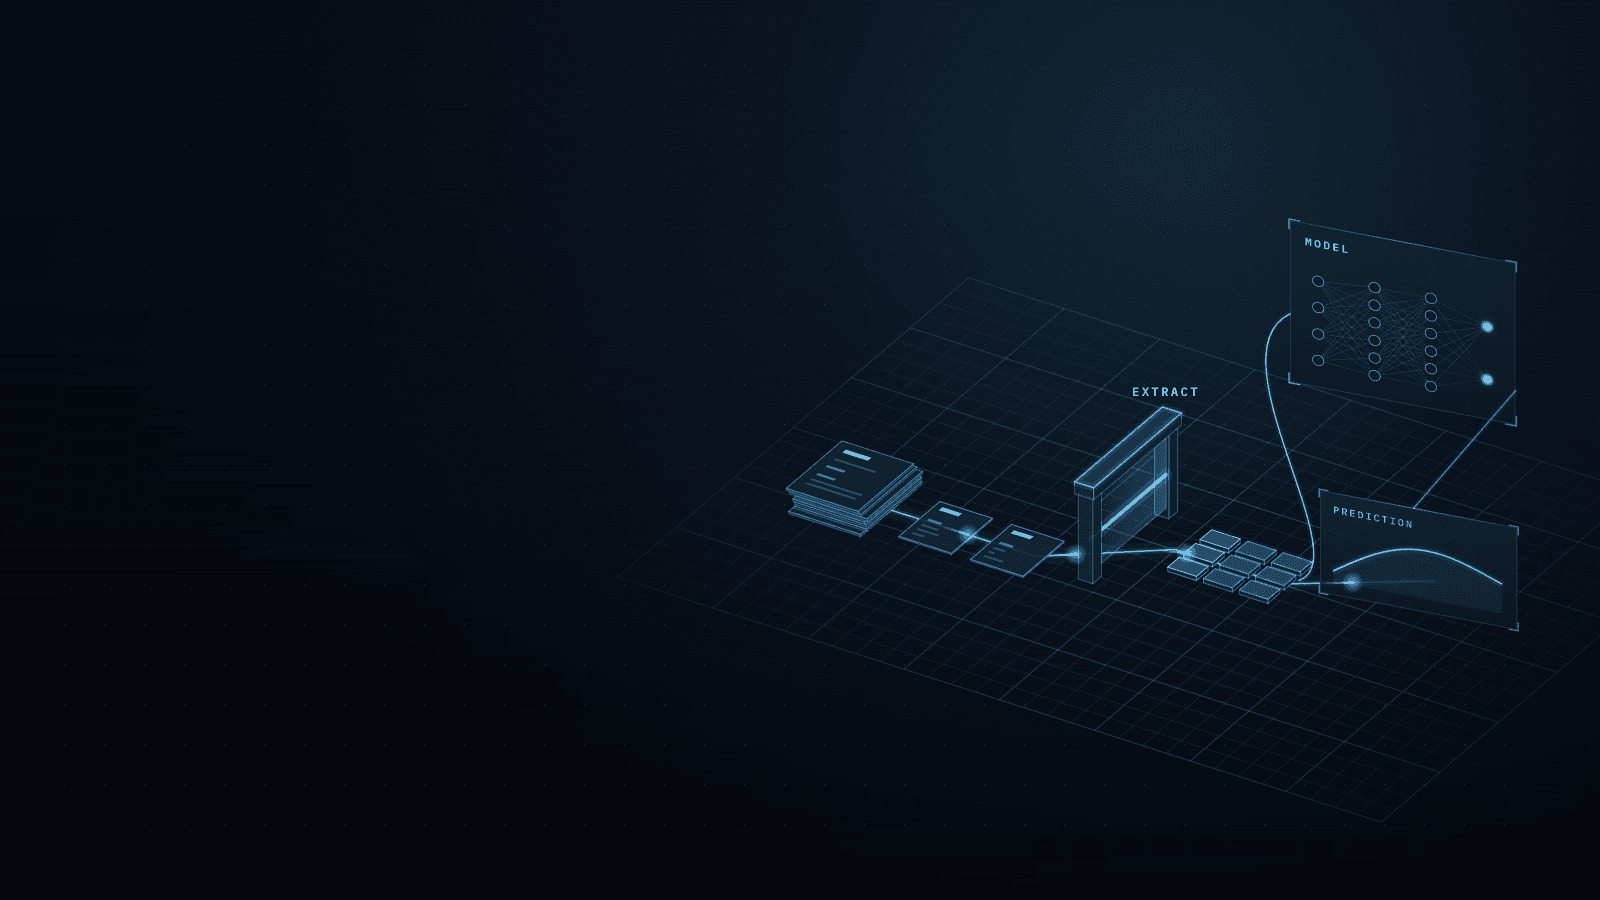
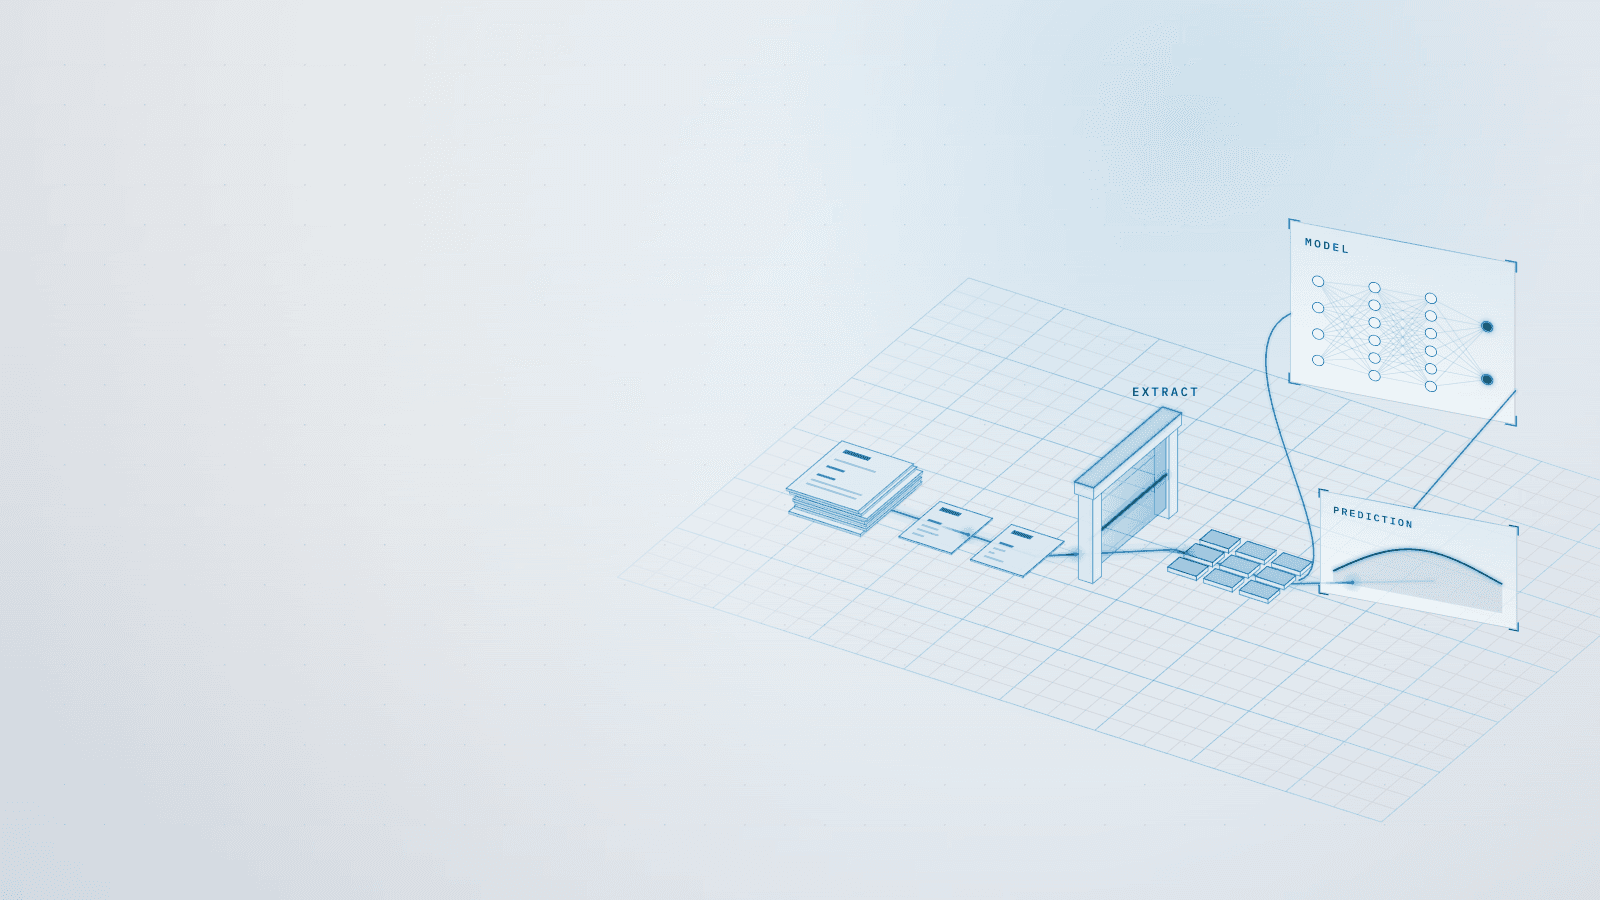
Una plataforma orientada a eventos que lleva documentos PDF y archivos de log de máquina desde la carga hasta la predicción sin intervención manual. Un cliente web encola cada trabajo; funciones serverless enrutan los documentos a un servicio de OCR gestionado, pipelines ETL limpian y cruzan los datos extraídos con los logs, y un modelo en contenedor sirve las predicciones.
Leer más
Lo diseñé como un sistema completo de ingeniería de datos y MLOps, con reentrenamiento mensual que promueve el mejor modelo a la API de predicción.
6 conexiones· elige un componente para ver su recorrido
- Cliente web a Cola de trabajos: órdenes de trabajo
- Cola de trabajos a Función enrutadora PDF: evento de carga en S3
- Función enrutadora PDF a Servicio OCR gestionado: PDFs generados por lásermodificado
- Servicio OCR gestionado a Pipelines ETL: texto crudo vía data lake
- Logs de máquina a Pipelines ETL: logs de máquina
- Pipelines ETL a Modelo reentrenado/mes: tablas de variables limpias
02Qué logró
Resultado
- Ingesta: un flujo manual y propenso a errores → automatizado desde la carga hasta la predicción
- Calidad de datos: PDFs y logs de máquina limpiados y cruzados de forma consistente por dos pipelines ETL
Leer más
- Ciclo de vida del modelo: reentrenamiento mensual, con el mejor modelo promovido a la API de predicción
- Operabilidad: tres funciones orientadas a eventos con trazabilidad y monitoreo de principio a fin
El desafío
Las entradas eran inconsistentes por naturaleza: los PDFs de cada fuente requerían un tratamiento diferente, y los logs de máquina tenían sus propios formatos y ruido. Una función enrutadora inspecciona cada documento entrante y envía los generados por láser a través del OCR gestionado; la extracción cruda se guarda en un data lake antes de cualquier transformación, de modo que cada paso se puede volver a ejecutar y verificar.
Leer más
Un modelo en producción, además, sufre deriva, así que el sistema necesitaba un ciclo de entrenamiento propio en lugar de un modelo entrenado una sola vez: reentrenamiento programado con datos recientes y promoción automática del mejor modelo. Con tantas funciones involucradas, la trazabilidad y el monitoreo de todo el flujo fueron parte del diseño, no un añadido posterior.
Qué aprendí
Construir el modelo fue la parte menor; la plataforma a su alrededor es lo que lo hizo útil. Enrutar los documentos por tipo antes del OCR, guardar los datos crudos antes de transformarlos y mantener el ETL separado de la predicción hizo que cada etapa fuera comprobable por sí sola.
Leer más
Tratar el entrenamiento como un trabajo programado y automatizado convirtió el modelo en algo mantenible en producción, no en un resultado puntual. La trazabilidad entre funciones es lo que hace depurable un sistema orientado a eventos.
Stack
- S3
- DynamoDB
- Textract
- Lambda
- ECR
- EventBridge
- CloudWatch
- X-Ray
- API Gateway
- React
- Docker
- Python
- ETL
- JavaScript
- scikit-learn
Habilidades
- Arquitectura orientada a eventos
- MLOps
- Procesamiento de documentos y OCR
- Diseño de ETL
- Operación serverless